Notizen Praxisnotiz
PRAXISNOTIZ · 14. OKTOBER 2026 · 3 MIN. LESEZEIT
Simultandolmetschen mit KI, was ich gemessen habe
Simultandolmetschen mit KI lag in meinen Messungen bei rund fünf Sekunden Verzögerung und zeigte im Dauerlauf mehrere Ausfälle.
Beim Simultandolmetschen mit KI kam der übersetzte Ton in meinen Messungen nach rund fünf Sekunden. Von 67 Namen und Fachbegriffen wurden mit Glossar und Nachbearbeitung 37 richtig übertragen, ohne Glossar waren es 19. Im Dauerbetrieb blieben Ausgaben aus, und Verbindungen wurden nach 60 Minuten beendet.
Der Ton durchläuft eine feste Kette
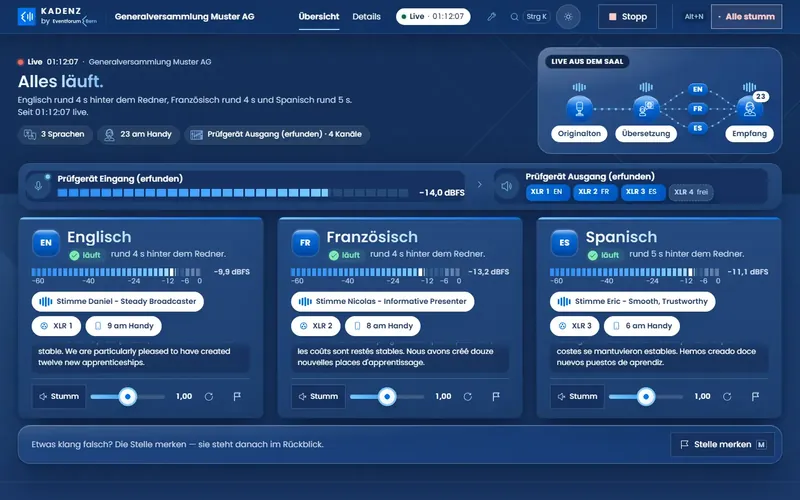
Seit August 2026 entwickle ich KADENZ als KI-Dolmetscher. Den Aufbau dokumentiere ich auf der Projektseite KADENZ. Der Ton kommt über einen eigenen Ausgang vom Mischpult in ein Audio-Interface. Dieses Gerät führt Audiosignale in die Verarbeitung und wieder heraus. Das verwendete Interface hat vier Ausgänge. Je Sprache führt ein Ausgang zu einem digitalen Funksender. Die Gäste hören die Simultanübersetzung über Empfänger im Saal.
KADENZ kennt drei Betriebsarten. In der ersten erledigt ein Modell die Erkennung, Übersetzung und Sprachausgabe in einem Schritt. In der zweiten erkennt ein Modell den Text, ein weiteres übersetzt ihn, danach spricht eine KI-Stimme. In der dritten laufen Erkennung und Übersetzung gemeinsam in einem Strom, gefolgt von der Sprachausgabe.
Der Dauerlauf zeigte stille Ausfälle
Am 4. August 2026 liess ich eine Aufnahme von 65 Minuten über drei Verbindungen gleichzeitig laufen. Ab Minute 35 lieferte die Erkennung rund 25 Minuten lang keine Ausgabe. Die Verbindung blieb bestehen, und es erschien keine Fehlermeldung.
Aus diesem Befund entstand eine Totmannschaltung. Das ist eine Überwachung, die bei ausbleibender Aktivität eingreift. Wenn Ton anliegt und während 20 Sekunden keine Ausgabe kommt, baut KADENZ die Verbindung neu auf.
Bei Minute 60 beendete der Anbieter alle drei Sitzungen. Der Wiederaufbau dauerte 1,8 Sekunden. Für einen Anlasstag plane ich deshalb überlappende Sitzungen mit einer vorherigen Übergabe ein.
Latenz und Genauigkeit lassen sich trennen
Latenz bezeichnet den Abstand zwischen dem gesprochenen Wort und der Verarbeitung. Am 4. August 2026 lag die Spracherkennung im Median 3,2 Sekunden hinter dem Redner. Die englische Übersetzung folgte nach 4,5 Sekunden, mit einer Spanne von 3,8 bis 7,0 Sekunden. Bis zum hörbaren Ton vergingen rund fünf Sekunden.
Ein Glossar ist eine Liste mit vorgegebenen Namen und Fachbegriffen. Mit Glossar und Nachbearbeitung kamen 37 von 67 Begriffen richtig durch. Ohne Glossar waren es 19. Jeder zusätzliche Treffer hing damit zusammen, dass der Begriff bereits in der Erkennung vorkam.
Ein Glossareintrag erhöhte die Trefferquote eines Begriffs von 21 auf 75 Prozent. Ein verhörtes Wort blieb bei 0 Prozent, weil es im erkannten Text nie auftauchte. Das Glossar konnte damit Übersetzungsfehler reparieren. Hörfehler entstanden bereits in der Spracherkennung.
Ein neueres Modell traf im Test vom 10. September 2026 die Wörter besser. Seine Ausgabe lag 2,0 Sekunden zurück. Die bestehende Kette lag bei 0,6 Sekunden, weshalb ich bei ihr blieb.
Mehrere Stimmen verändern den Betrieb
Im Selbsttest vom 30. September 2026 liefen drei Sprachen gleichzeitig. Je nach Stimme lag die Ausgabe 4,2 bis 4,4 Sekunden oder 4,6 bis 4,8 Sekunden hinter dem Redner. Das erste Wort kam nach 1,5 Sekunden oder nach 2,0 bis 2,4 Sekunden.
Über 93 Minuten blieb der Abstand stabil. Die gemessene Drift betrug minus 4,7 Millisekunden pro Minute. Bei zwei gleichzeitigen Verbindungen zur Sprachausgabe fehlte bei 17 von 40 Stimmen Text. Es gab weder einen Fehlercode noch eine Warnung. Mit einer Verbindung kamen alle Stimmen vollständig. Seit dem 30. September 2026 laufen höchstens drei Zielsprachen gleichzeitig.
Eine Anzeige für den Abstand zum Redner meldete bei einem Probedurchlauf am 1. Oktober 2026 einen Wert von 14 Sekunden. Beim Zurückhören waren es 4,1 Sekunden. Ich ersetzte die Anzeige. Vor jeder Version laufen über 150 automatische Prüfungen. Am 2. Oktober 2026 waren es 155 Programme ohne Fehler.
Was ich daraus mitnehme
Für mich besteht Echtzeit-Übersetzung aus mehreren getrennten Messgrössen. Tempo, Erkennungsqualität und Stabilität entwickeln sich nicht automatisch gemeinsam. Der Dauerlauf hat mir zudem gezeigt, dass eine bestehende Verbindung noch keine laufende Ausgabe belegt.
Modell dieser Notiz: gpt-5.6-sol.
 Zum ProjektPONTAVOX, Simultanübersetzung mit KI→